L’IA si forma sul “paziente medio”, ma la realtà è molto più complessa
Malattie, lingue, contesti geografici e sociali: gli algoritmi che governano la diagnostica e guidano nell’individuazione delle cure sottostimano le infinite variabili che incidono su ogni singolo caso. Riequilibrare i modelli è un dovere di giustizia
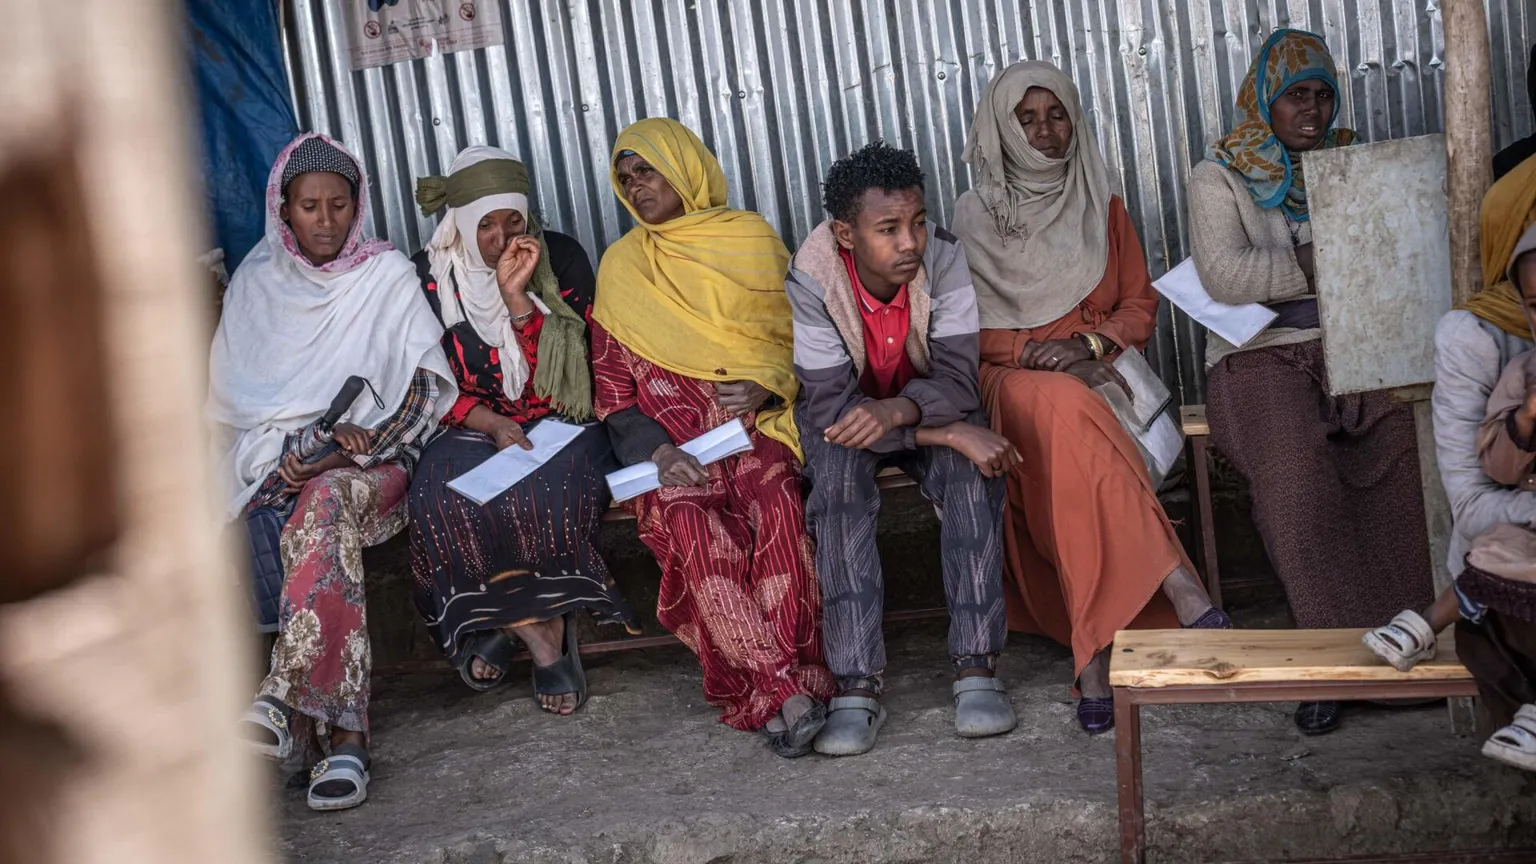
Un operatore sanitario nell’Africa subsahariana si affida a un modello linguistico per decidere chi visitare per primo; un uomo dell’India rurale chiede consiglio sulla propria salute nella lingua del suo villaggio, l’unica in cui il suo malessere abbia un nome. Con queste due scene oltre sessanta ricercatori, tra i quali figurano esponenti della Organizzazione mondiale della sanità e della Unione internazionale delle telecomunicazioni, presentano sulla rivista scientifica “Nature Medicine” MAGIC, una rete internazionale per valutare l’intelligenza artificiale generativa nella salute globale.
La diagnosi da cui partono è sobria e severa insieme: questi sistemi vengono misurati su batterie di test controllate e scenari predefiniti, mentre finiranno in ambienti clinici eterogenei, e sono progettati quasi sempre in contesti lontani da quelli in cui verranno usati. Un modello capace di superare un esame di medicina in inglese avrebbe dimostrato di conoscere il manuale; resterebbe da vedere se capisca chi descrive i sintomi con le parole della propria cultura, dentro un carico di malattie che il manuale relega in nota.
Il benchmark è un esame, e ogni esame è scritto da qualcuno. Chi sceglie le domande decide che cosa conti come sapere, e quindi chi venga visto. Una prova costruita su casi da manuale premia la risposta esatta in astratto e ignora la domanda che il paziente reale non sa formulare. La medicina conosce da tempo il rischio del paziente medio, quella figura statistica che non giace in nessun letto d’ospedale e sulla quale per decenni si sono tarati farmaci e protocolli; con l’intelligenza artificiale lo stesso scarto si moltiplica alla velocità con cui un software si distribuisce. Se la verifica resta nei laboratori del Nord, il collaudo vero avverrà altrove, e lo pagherà chi ha meno tutele e meno voce per protestare quando la macchina sbaglia.
C’è poi una ferita più sottile. Miranda Fricker ha chiamato ingiustizia epistemica il torto di chi non viene creduto, o non viene compreso, a causa di chi è. Un sistema che fraintende il dialetto con cui una madre descrive la febbre del figlio commette un errore di classificazione, e insieme sottrae credibilità a una testimonianza. Il paziente parla, e la macchina registra rumore; la decisione clinica che ne discende porta il peso di quel fraintendimento.
Qui sta il merito della proposta: riportare la valutazione nel luogo della cura, riconoscendo che la lingua locale, il peso delle malattie e il contesto sociale fanno parte della competenza clinica. Misurare bene diventa così un atto di giustizia, perché rende visibile chi i dati avevano lasciato ai margini. Gli autori dichiarano peraltro che una fondazione finanzia sia alcuni membri della rete sia organizzazioni i cui strumenti ricadrebbero sotto lo standard proposto. La trasparenza va riconosciuta; la domanda antica su chi custodisca i custodi resta aperta, e una rete che vuole certificare l’affidabilità altrui dovrà rispondervi con istituzioni, prima che con dichiarazioni.
La salute appartiene sempre a qualcuno, in un luogo e in una lingua. Una macchina chiamata a curare va giudicata là dove si soffre, davanti a quel volto.
© RIPRODUZIONE RISERVATA
 Seguici anche su Google Discover di Avvenire